Column
コラム
AI Deep Dive【45】案件に最適なLLMをどう選ぶ? 社内リーダーボード構築の取り組み
2026.11.05

昨今、さまざまなLLMが相次いで登場しています。しかし、性能や得意分野はモデルによって異なり、案件に適したモデルを選ぶには複数の評価結果を横断的に確認する必要があります。
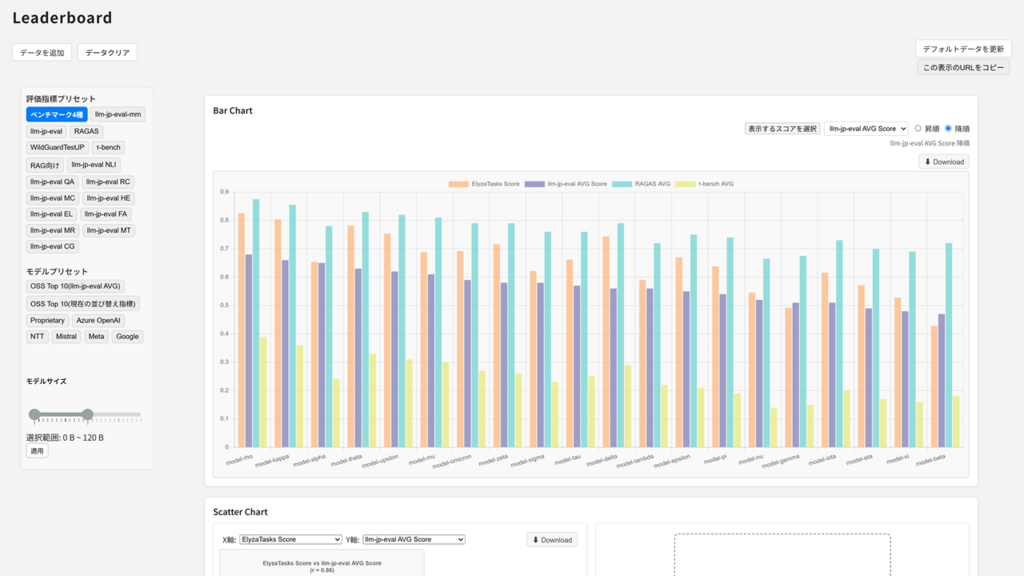
そこで私たちのチームでは、独自に測定したベンチマーク結果を集約し、比較できる社内向けLLMリーダーボードを構築しました。
本記事では、その背景や仕組み、主な機能を紹介します。
LLMの性能をどう比較するのか
LLMの進化は非常に速く、日々新たなモデルが発表されています。
私たちのチームでは、各モデルがどの程度の性能を持ちどんなタスクに強いのかを独自に測定することで、案件でモデルを選定する際に役立てています。
モデルの性能を測定し比較する手段の一つがベンチマークです。
ベンチマークとはLLMの能力を客観的に比較するための仕組みです。公開された評価用データセットと、採点方法がペアになっており、知識・推論・コーディング・日本語能力など、測りたい能力ごとにさまざまなものが存在します。
また業務では資料を参照してLLMに回答を生成させることがよくありますが、知識問題で高得点のモデルが参照資料を適切に使って回答できるとは限りません。そのため一つのベンチマークだけで判断せず、案件で重視する能力に合わせて複数の評価結果を確認する必要があります。
なぜ社内向けリーダーボードを自作したのか
モデル選定の参考として、まず公開されているリーダーボードを確認しました。リーダーボードとは複数のモデルの評価結果を一覧にし、比較できるようにしたものです。
ベンチマークごとのスコアから特定のタスクに強いモデルを探せるほか、リーダーボードによっては速度や価格など、性能以外の情報も比較できます。
たとえば、Artificial Analysis[1] ではモデルの性能に加えて速度や価格なども比較できます。
日本語に関わる評価を見る際にはSwallow LLM Leaderboard[2] も参考になります。
しかし今回はこれらを利用せず、独自のリーダーボードを作成することに決めました。
主な理由は次の3つです。
- 案件の目的に応じて、ベンチマークの指標を自由に組み合わせて評価したかった
- リリースされて日の浅いモデルの性能を比較したかった
- 自分たちでチューニングしたモデルについて、チューニング前後で性能がどう変化したかを追跡したかった
既存の公開リーダーボードではこれらの要件を満たすことは難しいと考えました。そこで公開リーダーボードを参考にしつつ、自分たちでベンチマーク測定、評価結果の管理、リーダーボードによる可視化を行うことにしました。
Excel管理からMLflowへ
当初、測定結果はExcelで管理していました。しかし、モデルや測定条件、評価指標が増えるにつれて、結果の管理と比較が難しくなりました。
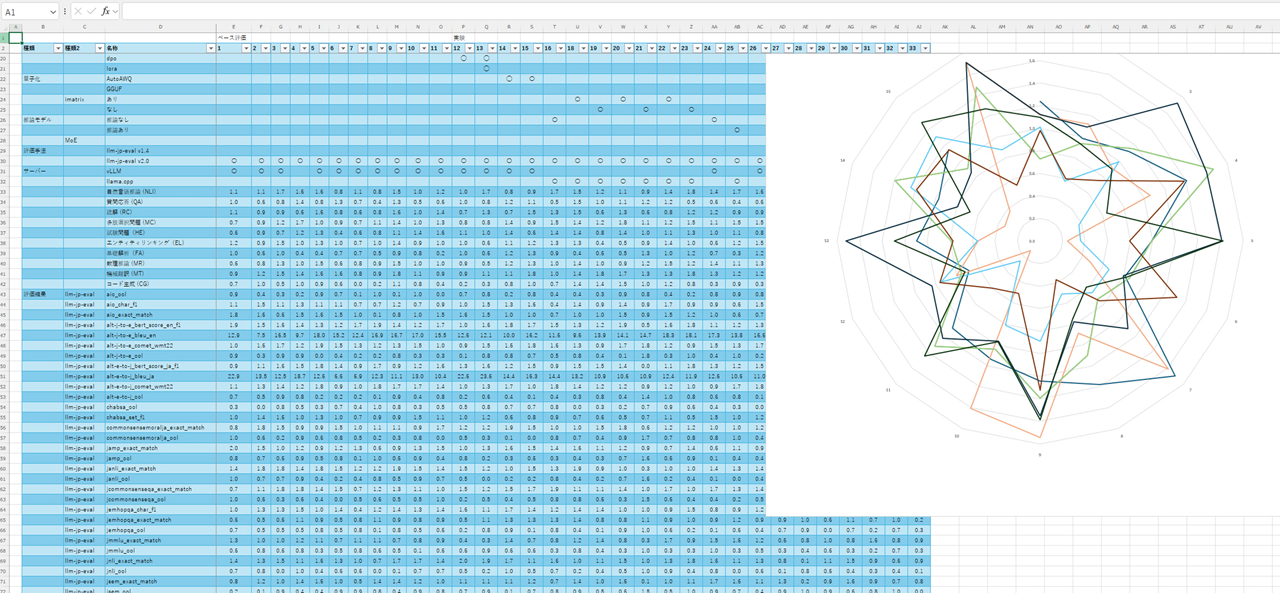
この課題に対応するため、測定結果を蓄積し、目的に応じて比較できる社内向けリーダーボードを作成しました。
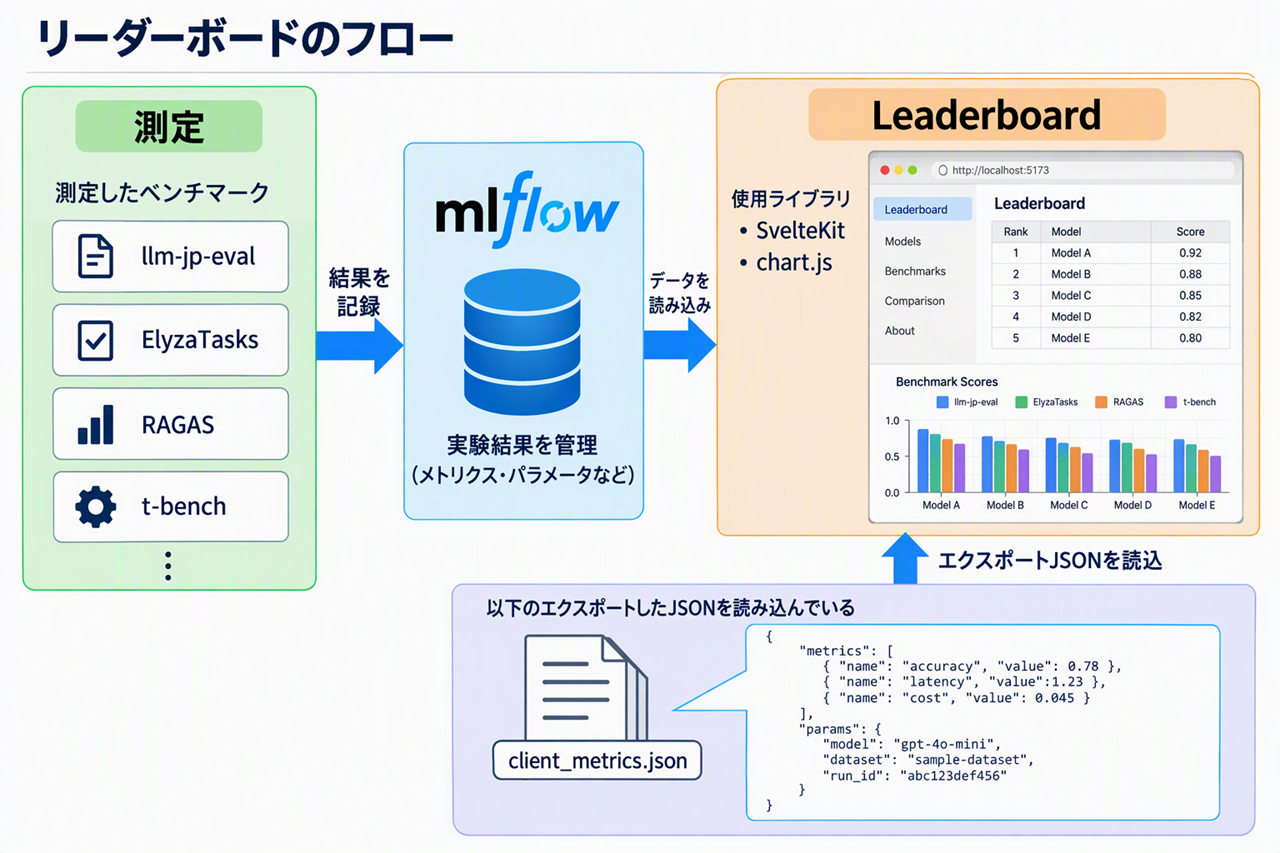
まず、さまざまなベンチマークでLLMの性能を測定し、その結果をMLflowに蓄積していきます。MLflowは機械学習モデルの開発から運用までのライフサイクルを一元管理するためのOSSプラットフォームで、以前からLLMのチューニングで利用していました。
リーダーボード作成でもこのMLflowを活用し、特にその中でも実験条件や評価結果を記録・管理するExperiments機能を使用してベンチマーク結果を保存しています。
どの条件でどの結果が出たのかを後から追跡できるため、チューニング前後の比較にもそのまま活用できます。
MLflowから測定結果をエクスポートしてJSON形式に整形します。リーダーボードはこのJSONを読み込んで表示します。
リーダーボードの機能
リーダーボードは開発メンバーがアクセスできるネットワークに公開しました。
これによって、メンバーそれぞれが欲しい情報に直接アクセスできるようになりました。
リーダーボード全体に共通する機能として、ベンチマークとモデルそれぞれのプリセットを用意しています。これにより、たとえば「Google製モデルのRAG関連ベンチマークのみ」といった絞り込みが簡単にできます。
また、モデルのサイズによる絞り込みにも対応しました。「30B程度のモデルだけを見たい」「100Bを超える大規模モデル同士で比較したい」といったニーズがあったためです。
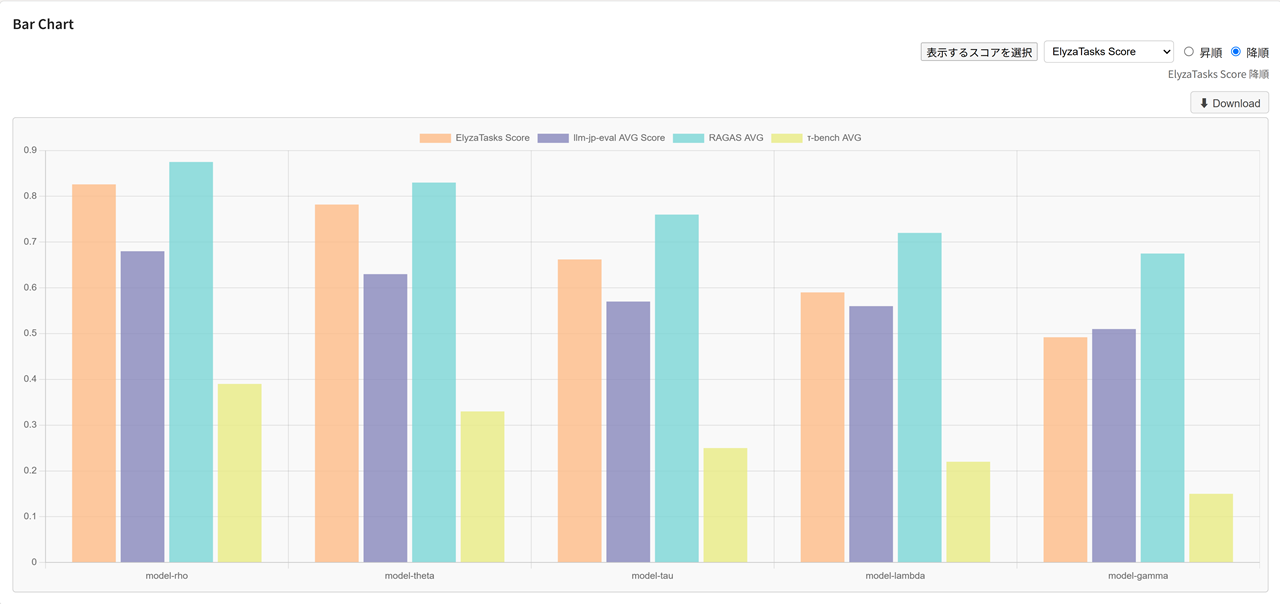
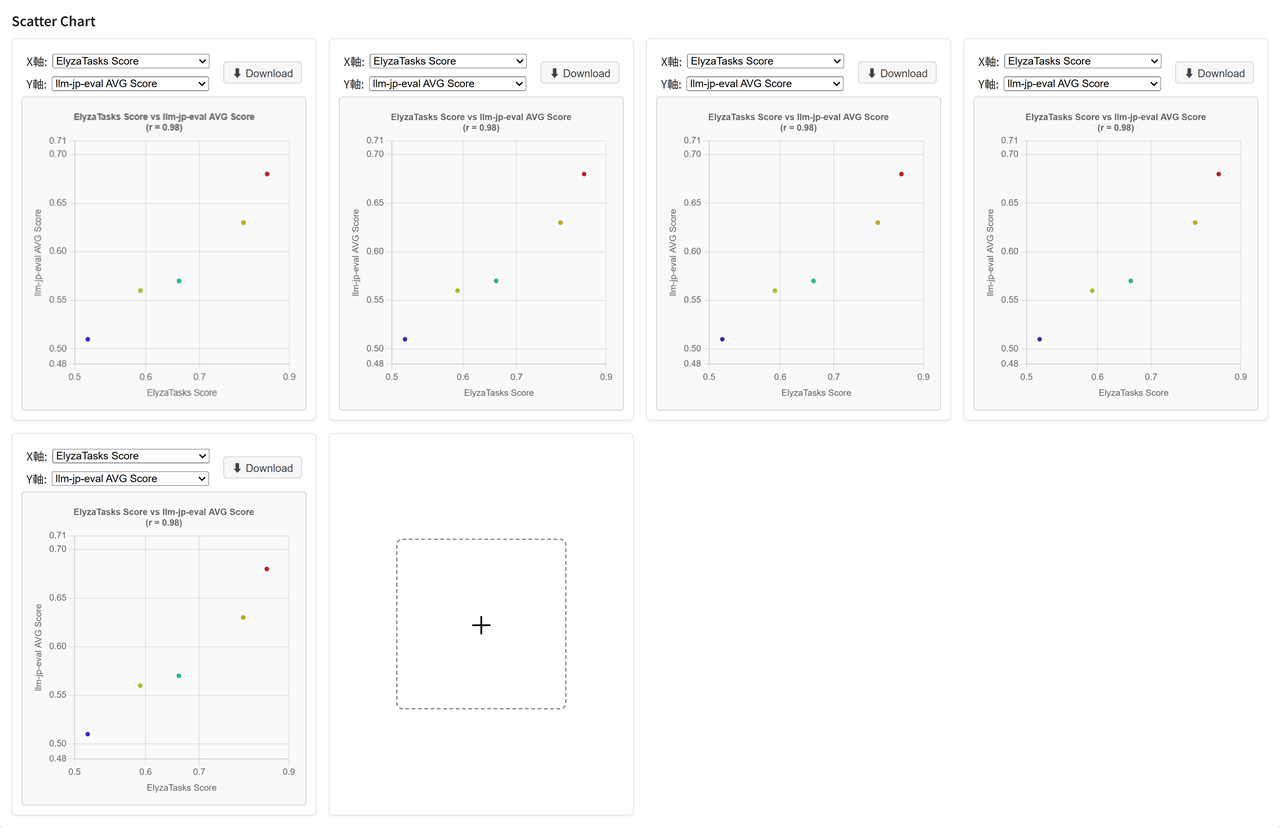
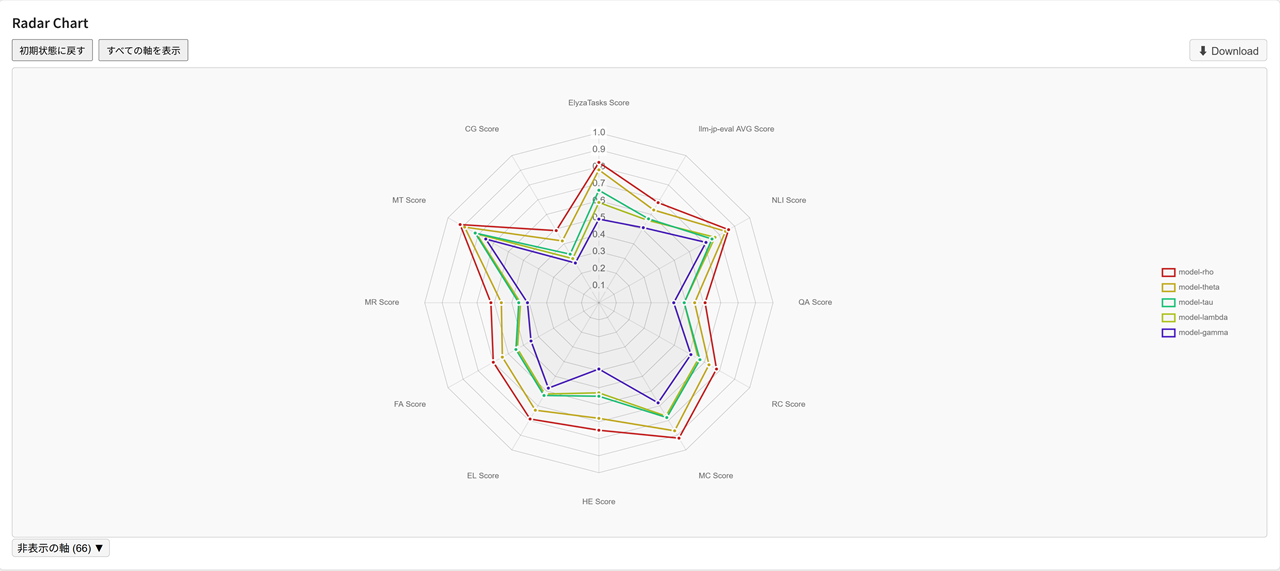
グラフ表示は棒グラフ・散布図・レーダーチャートの3種類で、いずれも画像としてダウンロードできます。
棒グラフでは、各モデルのスコアを並べて比較できます。ベンチマークごとに昇順・降順で並び替えられるため、タスクごとにモデルのランキングを簡単に把握することができます。
散布図では、X軸とY軸にそれぞれ任意のベンチマークを設定できます。
これにより、たとえば知識を問うベンチマークとRAG関連のベンチマークを並べることで知識問題で高得点のモデルが、RAGを用いるタスクでも高いスコアを出しているかを確認できます。
一つの指標だけでは見えないモデルの得意・不得意を把握し、案件に合う候補を絞り込むことに役立ちます。
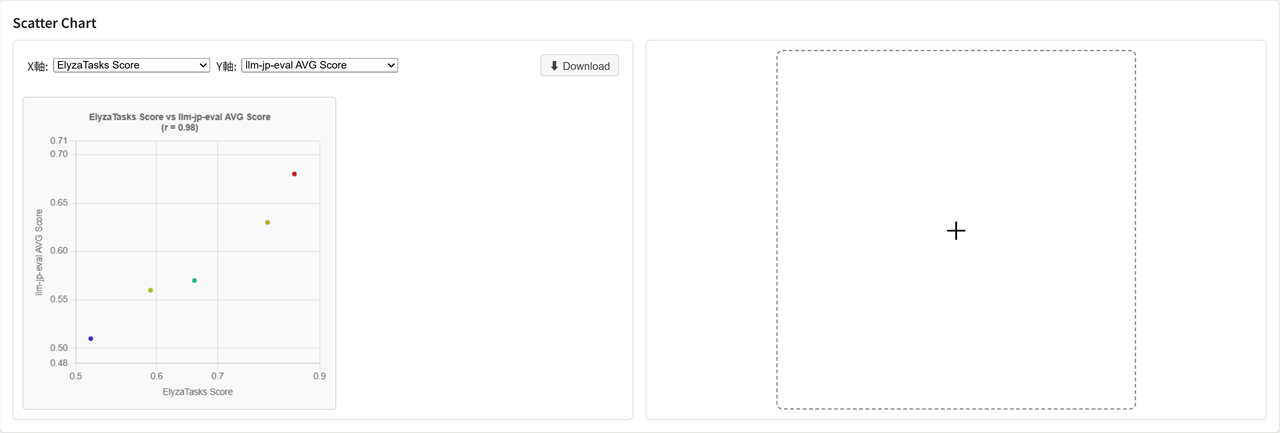
また、プラスボタンを押すことで散布図を自由に追加できます。
レーダーチャートでは、モデル同士を複数の観点から比較できます。各LLMの得意・不得意を視覚的に把握しやすく、軸の追加・削除も可能です。
終わりに
本記事ではチームで運用している社内向けLLMリーダーボードについて紹介しました。
測定結果をMLflowに集約しリーダーボードで可視化することで、Excelでは難しかった多数のモデルの比較や、チューニングによる性能変化の把握が容易になりました。
また、案件で重視する能力に応じて評価指標を組み合わせることで、単一のスコアだけに頼らず、用途に合ったモデルを検討できるようになりました。
今後も新しいモデルや評価指標を追加し、モデル選定を支える仕組みとして改善していきます。
※参考文献
[1] Comparison of Models: Intelligence, Performance & Price Analysis, https://artificialanalysis.ai/models(2026年10月2日閲覧)
[2] Swallow LLM Leaderboard v2, https://swallow-llm.github.io/leaderboard/index-post.ja.html(2026年10月2日閲覧)
執筆者
佐野 龍太郎(さの りゅうたろう)
NTTアドバンステクノロジ株式会社
アプリケーション・ビジネス本部 AIXソリューションビジネス部門 ジェネレーティブAIX担当
入社以来、自然言語処理分野に携わる。 社内リーダーボードを構築し、ローカルLLM・独自の追加学習モデルの評価を担当。現在は生成AIを利用したアプリの開発や、LLMシステム設計に従事している。
お問い合わせ
AI Deep Dive
このコラムは、NTT-ATのデータサイエンティストが、独自の視点で、AIデータ分析の技術、市場、時事解説等を記事にしたものです。本コラムの著作権は執筆担当者名の表示の有無にかかわらず当社に帰属しております。
次回は、"AIエージェント時代におけるHITLの重要性 ~AIが考え、人が決める~" について、2026年12月1日に掲載する予定です。
なお、ローカルLLM活用でお困りの場合は、「お問い合わせ」リンクよりどうぞご連絡ください。