Column
コラム
AI Deep Dive【44】小さなLLMを支えるRAGの工夫
2026.10.06

生成AIの性能は急速に向上しています。一方、企業でAIを活用する際には、性能だけでなくセキュリティや実行環境も考慮する必要があります。そのため、比較的小規模なLLMを自社環境で運用する「ローカルLLM」が選択される場面もあります。本コラムでは、小規模なLLMを活用する方法の一つである「RAG」に注目し、その精度や信頼性を高めるための工夫を紹介します。
はじめに
ChatGPTをはじめ、生成AIの性能は急速に向上しています。特に、その時点で最先端クラスの性能を持つ大規模なAIモデルは「フロンティアモデル」と呼ばれ、高度な推論や幅広い知識を必要とするタスクで高い性能を発揮します。
一方、企業でAIを活用する際には、性能だけでなくセキュリティなども考慮する必要があります。そこで選択肢となるのが、比較的小規模なLLMを自社のサーバーなどで動かす「ローカルLLM」です。データを外部サービスへ送信せずに処理できる構成を取りやすく、用途に合わせて実行環境を管理できるメリットがあります。
本コラムでは、こうした小規模なLLMを活用する方法の一つとして「RAG」に注目し、その精度や信頼性を高めるための工夫を紹介します。
小さなLLMの課題
小規模なLLMはフロンティアモデルと比べ、幅広い知識や複雑な推論を必要とするタスクを苦手とする場合があります。特に医療・法務・金融のような専門領域では、モデルが持つ知識だけに頼って回答させることは簡単ではありません。
そこで活用される技術の一つが、質問に関連する情報を外部の文書から検索し、その情報をLLMに与えて回答を生成する「RAG(Retrieval-Augmented Generation)」という仕組みです。しかし、RAGを組み合わせれば自動的に高精度な回答が得られるわけではありません。適切な文書を検索できなかったり、大量の文章に必要な情報が埋もれたり、複数の文書で異なる情報が記載されていたりすることもあります。
特に小規模なLLMを活用する場合には「LLMが回答しやすい情報を、適切な形で渡す」ためのRAG側の工夫が重要になります。
RAGは「検索して渡せば終わり」ではない
RAGでは、ユーザーの質問に関連する文書を検索し、その内容をLLMに渡して回答を生成します。一見すると、「正しい情報を検索してLLMに渡せば、正しい回答が得られる」と考えられそうです。しかし、実際のRAGではそう単純ではありません。
まず問題になるのが、必要な情報を正しく検索できるとは限らないことです。ユーザーの質問と文書で異なる表現が使われていたり、専門用語や略語が含まれていたりすると、本当に必要な文書が検索結果の上位に現れないことがあります。反対に、質問と一部の単語が似ているだけの、回答には不要な文書が検索されることもあります。
では、検索する文書の数を増やせばよいのでしょうか。これも必ずしも解決策にはなりません。
LLMに大量の文書を渡すと、回答に必要な記述が他の情報に埋もれてしまうことがあります。また、検索結果に古い情報や関連性の低い情報が含まれていれば、それを根拠として誤った回答を生成する可能性もあります。
さらに、RAGが適切な文書を取得できたとしても、LLMがその内容だけに基づいて回答するとは限りません。LLM自身が持つ知識を混ぜたり、文書には書かれていない内容を補ってしまったりする、いわゆる「ハルシネーション」が発生する可能性があります。
特に小規模なLLMでは、大量の情報から重要な部分を見つけ出し、複数の情報を整理しながら正確な回答を生成することが難しい場合があります。
そのため、RAGでは単純に「検索して渡す」だけではなく、検索の精度を高める、不要な情報を減らす、回答に使う根拠を明確にするといった工夫が重要になります。
検索を賢くする
RAGの精度を高めるための第一歩は、LLMに渡す前の「検索」を改善することです。どれだけ高性能なLLMを使っても、回答に必要な情報を検索できなければ、正しい回答を生成することは困難です。
そのため、RAGでは単純な検索だけでなく、さまざまな手法を組み合わせて必要な情報を見つけやすくする工夫が行われています。
質問を「仮想的な回答」に変えて検索するHyDE
RAGでよく使われるベクトル検索は、文章の「意味の近さ」を利用して関連する文書を探します。しかし、ユーザーの質問と、その回答を説明した文書では表現や内容が大きく異なり、必要な情報をうまく検索できない場合があります。
そこで考案された手法の一つがHyDE(Hypothetical Document Embeddings)です。[1]
HyDEでは、ユーザーの質問からLLMに「仮想的な回答」を一度生成させ、その文章と意味の近い文書を検索します。質問をそのまま検索するよりも、実際の文書に近い表現を使って検索することで、関連する情報を見つけやすくするという考え方です。
まず根拠を探してから答える
検索の精度を高め、質問に関連する文書を取得できたとしても、まだ課題は残ります。検索された文書には、回答に必要な情報だけでなく、多くの関連しない情報が含まれているためです。
一般的なRAGでは、検索した複数の文章をまとめてLLMに渡し、その中から必要な情報を判断して回答を生成させます。しかし、この方法ではLLMが「必要な情報を探すこと」と「回答を考えること」を同時に行わなければなりません。特に入力する文章が長くなるほど、重要な情報を見落としたり、関係のない情報を回答に利用したりする可能性があります。
そこで考えられるのが、「Quote First, Then Answer(まず引用し、その後に回答する)」というアプローチです。[2]
この方法では、検索した文章からすぐに回答を生成するのではなく、まず質問に答えるための根拠となる箇所を抽出します。そして、抽出された原文をもとに、改めて回答を生成します。
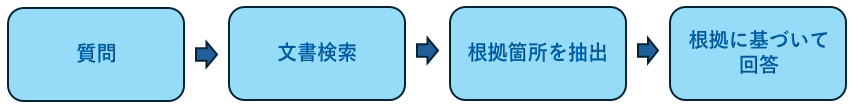
例えば複数の医学書から治療法について調べる場合、検索されたページをすべて使って回答するのではなく、「どの治療が推奨されているか」が記載された箇所を先に抜き出し、その情報を使って回答を作成します。
このように処理を分けることで、LLMが一度に行う仕事をシンプルにできます。また、回答に利用する情報をあらかじめ限定することで、与えられた文書に書かれていない内容を生成するハルシネーションの抑制も期待できます。
この考え方は、特に小規模なLLMを利用する場合に重要です。大量の文章から必要な情報を見つけ、内容を整理し、正確な回答を一度に生成させるのではなく、「根拠を探す」「根拠から答える」と処理を分解することで、モデルが取り組みやすい問題に変えることができます。
膨大な文書を「検索」から「比較」へ
扱う文書が増えてくると、単に「答えを探す」だけでは解決できない問題も出てきます。
その一つが、複数の文書に書かれた内容の違いを把握することです。
例えば、ある医学書では「治療法Aを推奨」と書かれている一方、別の医学書では「特定の条件では治療法Aを推奨しない」と記載されているかもしれません。さらに、新しいガイドラインでは推奨内容そのものが変更されている可能性もあります。
このような場合、単純なRAGでは、検索で上位に表示された文書だけをもとに回答してしまい、別の文書に異なる見解が存在することを見落とす可能性があります。
そこで、RAGを「答えを探す仕組み」だけではなく、複数の文書を比較する仕組みとして利用することが考えられます。
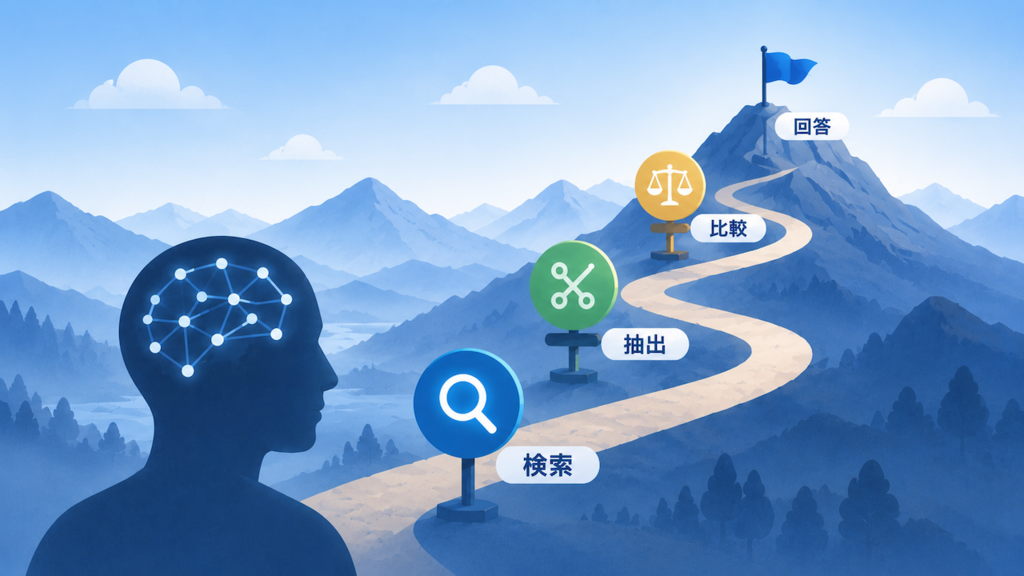
例えば、関連文書を検索 → 各文書から主張と根拠を抽出 → 主張を比較 → 一致・相違・矛盾を整理 というように処理を分解します。
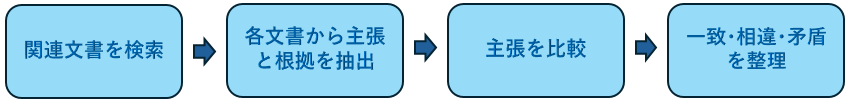
重要なのは、大量の文書をまとめてLLMに渡し、「違いを探してください」と指示するのではないことです。まず文書ごとに重要な主張を抽出し、その後で抽出した情報同士を比較することで、LLMが一度に処理しなければならない情報量を減らすことができます。
こうした仕組みを利用すれば、RAGは単に「質問に答えるための検索システム」ではなく、膨大な文書の中から「どこが同じで、どこが違うのか」「どの情報が新しいのか」まで整理するシステムへと発展させることができます。
小さなLLMを「システム全体」で賢くする
ここまで、RAGの精度や信頼性を高めるためのさまざまな技術を紹介してきました。これらに共通しているのは、すべての仕事をLLMだけに任せないという考え方です。
より大きく高性能なLLMを使えば、複雑な指示や大量の文章をうまく処理できる場面は増えるでしょう。しかし、企業で生成AIを利用する場合には、性能だけでなく、セキュリティ、実行環境など、さまざまな条件を考慮する必要があります。その結果、小規模なLLMを選択する場面もあります。
そのとき重要になるのが、「モデルを賢くする」のではなく、「モデルが答えやすい問題に変える」という発想です。LLMの周囲にある仕組みを工夫することで、小規模なLLMであっても、その能力をより効果的に引き出すことができます。RAGは検索、選別、根拠抽出、比較、検証といった処理を組み合わせ、LLMが回答しやすい環境を作るための仕組みとして捉えることができます。
モデルの性能競争が続く一方で、これからの生成AI活用では、どのモデルを使うかだけでなく、そのモデルを「システム全体でどう賢く使うか」も重要になっていくのではないでしょうか。
参考文献
[1] Precise Zero-Shot Dense Retrieval without Relevance Labels (Gao et al., ACL 2023)
[2] LLMQuoter: Enhancing RAG Capabilities Through Efficient Quote Extraction From Large Contexts (Bezerra et al., arXiv:2501.05554, 2025)
執筆者
石井 佑一 (いしいゆういち)
NTTアドバンステクノロジ株式会社
アプリケーション・ビジネス本部 AIXソリューションビジネス部門 ジェネレーティブAIX担当
検索エンジン開発、機械翻訳エンジン開発、生成AIシステム開発・コンサルなどの自然言語処理関連の業務に従事。近年は自治体や企業に対する生成AIシステムやRAGシステムの導入支援に注力。AIプリンシパルの社内資格を取得。
お問い合わせ
AI Deep Dive
このコラムは、NTT-ATのデータサイエンティストが、独自の視点で、AIデータ分析の技術、市場、時事解説等を記事にしたものです。本コラムの著作権は執筆担当者名の表示の有無にかかわらず当社に帰属しております。
次回は、"LLM社内リーダーボードの設計" について、2026年11月5日に掲載する予定です。
なお、RAGの構築や精度向上でお困りの場合は、「お問い合わせ」リンクよりどうぞご連絡ください。